Montag kommt ein neues Modell. Es steht ganz oben im Leaderboard, kann längere Aufgaben am Stück und kostet pro Token weniger als der Vorgänger. Mittwoch kommt das nächste. Viele Teams wechseln jedes Mal das Modell und wundern sich, warum im eigenen Projekt kaum etwas besser wird.
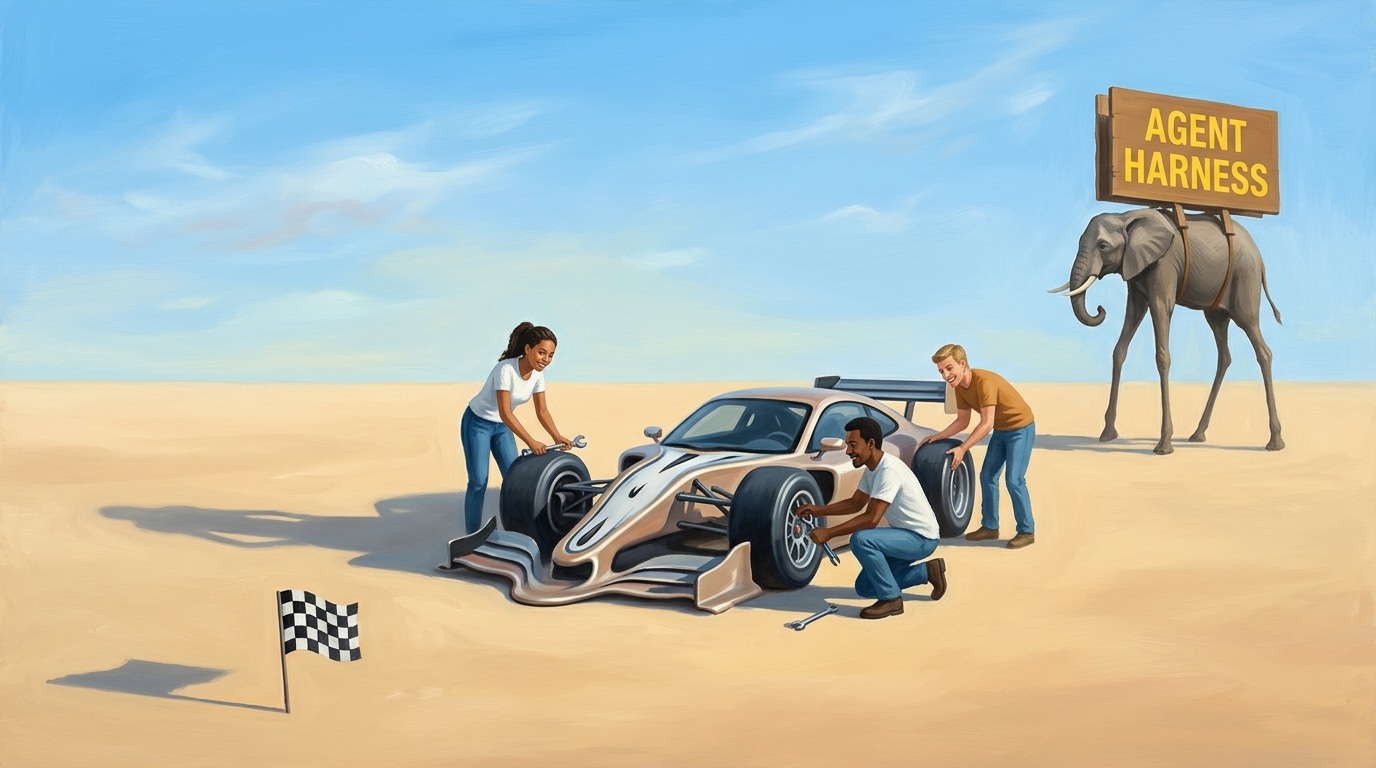
Ein Blick in die Boxengasse hilft. Im Motorsport gewinnt kein Team mit dem stärksten Motor allein. Fahrwerk, Abstimmung, Telemetrie, Boxenfunk und Strategie entscheiden mit. Beim KI Coding heißt dieser ganze Rest Agent Harness. Und genau dort entsteht ein großer Teil vom Ergebnis.
Das ganze Setup statt nur das Modell: Eure Developer lernen, Coding Agents mit Regeldateien, Permissions, Tests und Quality Gates sauber abzustimmen. Zum NCA KI Workshop für Developer
Was ist ein Agent Harness
Ein Agent Harness ist alles, was um das Sprachmodell herum gebaut ist. Das Modell liefert Text. Der Harness macht daraus einen Agent, der Dateien liest, Befehle ausführt, Fehler bemerkt und weiterarbeitet. Dazu gehören:
- Systemprompt und Regeldateien wie AGENTS.md, die bei jedem Start geladen werden
- Tools für Dateien, Shell, Suche und Diagnose
- Kontextverwaltung, also was im Fenster bleibt und was zusammengefasst wird
- Schleifen und Fallbacks, wenn ein Befehl scheitert oder ein Test rot wird
- Permissions, die festlegen, was der Agent ohne Rückfrage darf
OpenCode, Claude Code oder Codex sind solche Harnesses. Unter der Haube kann dasselbe Modell laufen, trotzdem fühlt sich die Arbeit damit völlig anders an. Wir setzen in Production auf OpenCode mit Open Weight Modellen. Warum Anbieter ihre Harnesses inzwischen auch gegeneinander abschotten, haben wir in Claude Code Harnesses und die Blockade von Anthropic eingeordnet.
Addy Osmani bringt es in seinem Beitrag Agent Harness Engineering auf einen Satz:
A coding agent is the model plus everything you build around it.
Addy Osmani
Was KI Leaderboards wirklich messen
Moderne Coding Benchmarks testen Modelle selten im leeren Chatfenster. Sie laufen in einem Agentensystem, das Aufgaben plant, Tools aufruft und Fehler abfängt. Was im Leaderboard steht, ist also die Rundenzeit eines kompletten Rennwagens. Osmani beschreibt in seinem Beitrag, dass dasselbe Modell in unterschiedlichen Harnesses auf Benchmarks sehr unterschiedlich abschneidet. Ein Team kam allein durch Änderungen am Harness von Platz 30 unter die besten fünf.
Für euch heißt das: Das Leaderboard sagt wenig darüber, wie das Modell in eurem Setup läuft. Ein neues Modell bringt euch nur dann weiter, wenn der Rest der Kette mithält. Darum lohnt es sich, Modelle selbst einzuordnen, wie wir es etwa bei GLM 5.3 von Z.ai getan haben.
Der Coding Agent als Rennwagen
Das Bild aus dem Motorsport passt erstaunlich gut. Jedes Teil hat ein Gegenstück im Agent Setup, und jedes Teil kann das Ergebnis ruinieren:
| Im Rennwagen | Im Agent Setup | Typischer Fehler |
|---|---|---|
| Motor | Sprachmodell | Teuerstes Modell für jede Kleinigkeit |
| Fahrwerk und Abstimmung | Harness Konfiguration | Standardeinstellungen, nie angepasst |
| Boxenfunk | AGENTS.md und Regeldateien | Keine Regeln oder widersprüchliche Regeln |
| Telemetrie | Tests, statische Analyse, Diagnose | Agent arbeitet blind, Fehler fallen erst im Review auf |
| Rennleitung | Permissions und Pipeline als Gate | Agent darf alles, auch Dinge, die niemand prüft |
| Tankstrategie | Token, Cache und Kosten | Cache bricht ständig, jeder Aufruf kostet voll |
Die Balance zählt. Ein Kartmotor gewinnt kein Langstreckenrennen, egal wie gut die Boxencrew ist. Ein winziges Modell bringt auch im besten Harness keine komplexe Architektur zustande. Umgekehrt verpufft das stärkste Modell, wenn es ohne Telemetrie und ohne Regeln fährt.
Wo Teams beim Coding Agent Geld liegen lassen
Wenn wir Agent Setups in Teams anschauen, finden wir die Bremsen fast immer an denselben Stellen.
Prompt Cache. Viele Anbieter rechnen Tokens, die aus dem Cache kommen, deutlich günstiger ab. Laut der Übersicht von Artificial Analysis zum Prompt Caching kosten gelesene Cache Tokens bei Anthropic rund ein Zehntel des normalen Eingabepreises. Der Cache greift aber nur, wenn der Anfang des Prompts exakt gleich bleibt. Ein Zeitstempel im Systemprompt oder eine Tool Liste, die sich ständig ändert, und jeder Aufruf kostet wieder voll. Das ist reine Harness Arbeit.
Diagnose für den Agent. Ohne Rückmeldung rät der Agent, ob sein Code funktioniert. OpenCode kann Language Server anbinden und deren Diagnosen an den Agent zurückgeben. Die OpenCode Doku zu LSP Servern sagt aber auch offen, dass das nicht in jedem Projekt hilft und Agents bremsen kann. Oft ist es besser, Lint, Typprüfung und Tests direkt laufen zu lassen. In PHP Projekten heißt das bei uns PHPStan, Psalm und PHPUnit, deren Ausgabe der Agent sofort sieht.
Regeln und Grenzen. Eine gute AGENTS.md spart lange Erklärungen in jedem Prompt. Saubere Permissions verhindern, dass der Agent Dinge tut, die niemand will. Wie das in OpenCode geht, zeigen OpenCode Permissions richtig einstellen und OpenCode Commands erstellen.
Modell passend zur Aufgabe. Nicht jede Umbenennung braucht das größte Modell. Kleine Aufgaben laufen gut mit kleinen Modellen, große Architekturfragen bekommen ein starkes Modell aus der Cloud. Wer die Kosten im Blick behalten will, setzt einen Proxy wie LiteLLM davor. Damit seht ihr Tokens und Kosten pro Nutzer und könnt harte Budgets setzen.
Daten für den Agent. Ein Agent, der nur gegen leere Datenbanken testet, findet viele Fehler nicht. Mit gemeinsamen Seed Daten arbeiten Menschen, Tests und Agents in derselben Welt. Mehr dazu in Seed Daten als Teamstandard.
Warum ein besseres KI Modell den Harness nicht ersetzt
Viele hoffen, dass das nächste Modell all diese Arbeit überflüssig macht. Unsere Erfahrung ist eine andere. Mit jedem stärkeren Modell bekommt der Agent größere Aufgaben, und damit wachsen auch die Fehler, die durchrutschen können. Warum Prüfschichten deshalb eher an Wert gewinnen, steht in Warum KI Guardrails mit jedem besseren Modell wertvoller werden. Was passiert, wenn die Kette fehlt, zeigt die Linux Foundation Studie aus unserem Beitrag AI Slop in Pull Requests.
Agent Setup im ganzen Unternehmen
Das Thema betrifft längst mehr als die Entwicklung. Auch Marketing, Vertrieb und Verwaltung bauen sich mit Coding Agents kleine Helfer. Wer dort einfach das teuerste Modell bucht und den Rest dem Zufall überlässt, zahlt viel und bekommt wenig. Im NCA KI Workshop für die Belegschaft arbeiten deshalb alle im Terminal mit OpenCode, das wir vorab einrichten. Die Developer lernen im NCA KI Workshop für Developer, wie sie Software Factories mit AI Guardrails aufbauen.
Den Vergleich mit dem Rennwagen nehmen wir dabei gern wörtlich. Für Unternehmen bereiten wir ein Format am Hockenheimring vor. Die Belegschaft baut mit Roland Golla eine eigene Astro App für echte Aufgaben aus dem Alltag. Parallel arbeiten die Developer mit Benjamin Klein am Agent Setup mit Guardrails. Abends gibt es eine Führung über die Strecke und E Kart. Den Termin stimmen wir jeweils mit dem Unternehmen ab.
Fazit
Das Leaderboard zeigt Rundenzeiten von kompletten Rennwagen. Euer Ergebnis hängt davon ab, wie gut euer eigener Wagen abgestimmt ist. Schaut euch die ganze Kette an: Modell, Harness, Regeln, Diagnose, Cache und Kosten. Sucht den Engpass und tunt dort. Ein neues Modell lohnt sich erst, wenn der Rest es auf die Straße bringt.
Euer Agent Setup richtig abstimmen
Wir schauen uns mit euch die ganze Kette an, von Modellwahl über Regeldateien und Permissions bis zu Quality Gates und Kosten. Im kostenlosen Kennenlernen schätzen wir den Aufwand, abgerechnet wird transparent auf die Minute.
